Cómo los clubes de fútbol utilizan el Big Data para decidir qué jugadores fichar
La inteligencia de datos permite analizar el rendimiento, las condiciones físicas y el potencial de miles de futbolistas, reduciendo los riesgos y costos de contratación sin reemplazar la evaluación de los ojeadores.

18 octubre, 2026 / 2:57 pm
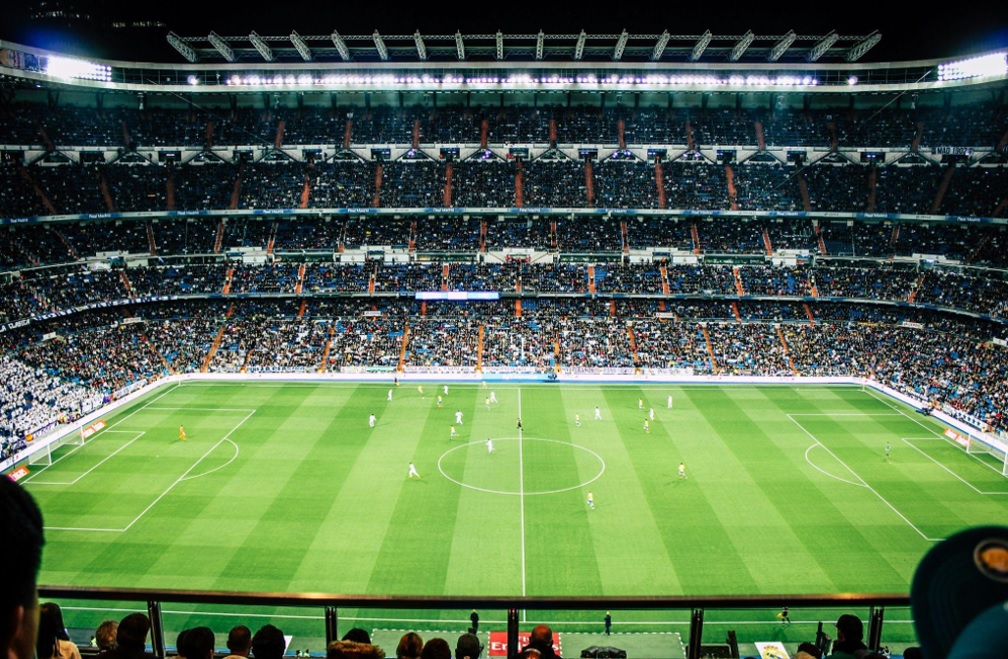
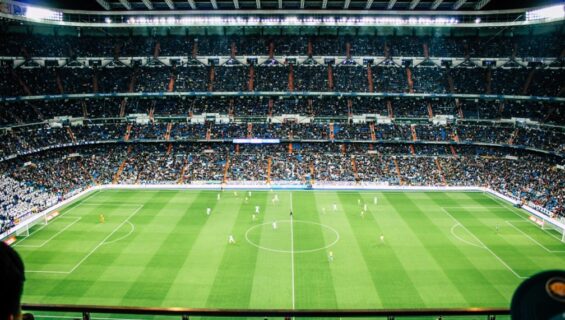
Photo by Vienna Reyes on Unsplash
Durante décadas, un fichaje empezaba con un ojeador sentado en la tribuna y terminaba con una conversación entre dirigentes. Ese circuito sigue existiendo, pero ahora convive con departamentos que procesan millones de acciones registradas en cientos de ligas.
El Big Data no reemplazó al scouting tradicional: cambió el orden de las tareas. Primero el modelo reduce miles de nombres a una lista corta según criterios objetivos, y recién después el ojeador viaja a ver en vivo a los candidatos que sobrevivieron al filtro. El resultado es un proceso más barato y con menos margen para el azar.
Parte de esa información dejó de ser exclusiva de los clubes. Portales estadísticos y secciones deportivas como Parimatch difunden métricas avanzadas que hace diez años solo circulaban en informes internos.
Qué tipo de datos analiza un club
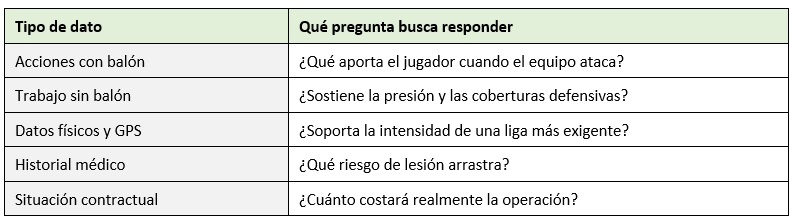
Los datos que analiza un club van bastante más allá de goles y asistencias. Cada categoría busca responder una pregunta distinta sobre el jugador:
Las métricas que desplazaron al conteo de goles
Las métricas avanzadas se popularizaron porque describen el proceso, no solo el resultado final. Estas son las más utilizadas en los informes de reclutamiento:
▸ Goles esperados (xG). Estima la calidad de las ocasiones generadas, más allá de si terminaron en gol.
▸ Asistencias esperadas (xA). Mide el peligro de los pases, incluso cuando el compañero falla la definición.
▸ Pases progresivos. Indica cuánto avanza el equipo gracias a ese futbolista.
▸ Acciones ajustadas por posesión. Corrige el sesgo de jugar en un equipo dominante o en uno replegado.
Advertencia metodológica: una temporada corta produce cifras engañosas. Un delantero puede superar ampliamente su xG durante quince partidos y volver al promedio después; por eso los clubes exigen muestras de varias temporadas antes de decidir.
El ajuste por nivel de liga
Comparar rendimientos entre campeonatos distintos es el problema técnico más difícil del reclutamiento. Un rendimiento sobresaliente en una liga menos competitiva no se traduce automáticamente en la misma producción al subir de categoría, por lo que los modelos aplican coeficientes de ajuste y aun así se equivocan con frecuencia. Cuanto mayor es el salto de nivel, menos confiable resulta la proyección.
Ejemplo práctico: dos extremos muestran cifras casi idénticas. El modelo revela que uno acumuló sus números frente a los últimos de la tabla y el otro contra rivales de mitad de tabla hacia arriba. Esa diferencia, invisible en la estadística básica, suele definir la decisión final.
Dónde termina el alcance del modelo
El modelo describe lo que ocurrió en el campo, pero no evalúa carácter, adaptación cultural ni vínculo con el vestuario. Tampoco anticipa cómo reaccionará un futbolista de veinte años al mudarse a otro continente. Esa parte del trabajo sigue dependiendo de entrevistas, informes de ojeadores y referencias personales de entrenadores anteriores.
Cómo contrastar los datos disponibles
Cualquier aficionado puede verificar buena parte de estos indicadores. Flashscore y Sofascore publican minutos y métricas individuales por partido, Transfermarkt documenta contratos e historiales de traspasos, y comparar varias fuentes evita sacar conclusiones a partir de una sola actuación destacada.
Preguntas frecuentes
¿El Big Data reemplaza a los ojeadores?
No. Reduce la lista de candidatos y ordena prioridades, pero la observación en vivo sigue siendo parte del proceso.
¿Por qué fracasan fichajes respaldados por datos?
Porque el rendimiento depende también del contexto táctico, del cuerpo técnico y de la adaptación personal, variables difíciles de modelar.
¿Qué clubes son más conocidos por este enfoque?
Instituciones como Brentford, Brighton y Midtjylland construyeron su reputación deportiva sobre modelos de reclutamiento basados en datos.
Para cerrar
El Big Data convirtió el reclutamiento en un proceso más ordenado y transparente, aunque no en una ciencia exacta. Los modelos filtran candidatos, corrigen sesgos y detectan perfiles que el ojo humano pasaría por alto, mientras la decisión final sigue combinando estadística, observación directa y criterio deportivo.
Vea Tambien:
Más leídas

Últimas Noticias
Actualidad
18 Oct, 2026 / 2:57 pm
Cómo los clubes de fútbol utilizan el Big Data para decidir qué jugadores fichar
Comercio exterior
18 Oct, 2026 / 10:15 am
ADEX advierte que El Niño Costero amenaza a pequeños agroexportadores y pide financiamiento urgente
Empresa
17 Oct, 2026 / 9:00 am
SMV actualiza el Código de Buen Gobierno Corporativo con foco en la sostenibilidad y fortalecimiento de los directorios
Microfinanzas
16 Oct, 2026 / 5:32 pm
Caja Ica promueve el acceso a soluciones financieras para emprendedores y pequeñas empresas
Actualidad
16 Oct, 2026 / 2:28 pm
Registro, verificación y mesas en vivo: así funciona el casino online en el Perú
Microfinanzas
16 Oct, 2026 / 8:00 am
Caja Arequipa casi duplica sus utilidades a setiembre y reduce su morosidad a 3,11%
Economía
16 Oct, 2026 / 8:00 am
Déficit fiscal acumulado baja a 0,9% del PBI a setiembre de 2026

Comercio exterior
16 Oct, 2026 / 7:00 am
Fletes de importación desde China a Perú se disparan 133,8%
NEWSLETTER

Suscríbase gratís a nuestro Newsletter.
Más leídas
Últimas Noticias
Actualidad
18 Oct, 2026 / 2:57 pm
Cómo los clubes de fútbol utilizan el Big Data para decidir qué jugadores fichar
Comercio exterior
18 Oct, 2026 / 10:15 am
ADEX advierte que El Niño Costero amenaza a pequeños agroexportadores y pide financiamiento urgente
Empresa
17 Oct, 2026 / 9:00 am
SMV actualiza el Código de Buen Gobierno Corporativo con foco en la sostenibilidad y fortalecimiento de los directorios
Microfinanzas
16 Oct, 2026 / 5:32 pm
Caja Ica promueve el acceso a soluciones financieras para emprendedores y pequeñas empresas
Actualidad
16 Oct, 2026 / 2:28 pm
Registro, verificación y mesas en vivo: así funciona el casino online en el Perú
Microfinanzas
16 Oct, 2026 / 8:00 am
Caja Arequipa casi duplica sus utilidades a setiembre y reduce su morosidad a 3,11%
Economía
16 Oct, 2026 / 8:00 am
Déficit fiscal acumulado baja a 0,9% del PBI a setiembre de 2026
Comercio exterior
16 Oct, 2026 / 7:00 am
Fletes de importación desde China a Perú se disparan 133,8%
NEWSLETTER
Suscríbase gratís a nuestro Newsletter.